Frida 17.6.2 魔改 rusda:编译实践与反检测 Patch 的技术剖析
本文以 Frida 17.6.2、父仓库基线提交 1ce4396d6e43d93c8604c4cd4578ff84871bcfa1(见 patches/deliver/README.txt)上的 rusda 定制为主线。
开源和编译产物地址:https://github.com/taisuii/rusda
Frida 17.6 发布没多久的时候,这边其实就已经开干了,只是前段时间一直比较忙,没来得及整理出来分享。
编译相关的 skill 和 patch 基本都已经放到 GitHub 里了。基础编译流程这里就不再展开,一方面 Frida 官网本身已有教程,另一方面也可以参考看雪这篇文章:
https://bbs.kanxue.com/thread-284739.htm
前言
现阶段魔改 Frida 的项目其实已经不少了,之前 16.2.1 版本也有过一轮比较集中的改动。这次重新折腾 17.6.2,主要还是因为 Frida 17.6 之后和以前确实有一些比较明显的区别,不少旧思路不能直接平移。
另外现在工具链迭代很快,很多东西更新也很快,继续盯着老版本做文章,意义没有以前那么大。所以与其反复围绕旧版本打补丁,不如多看看新版本到底改了什么、哪些地方值得跟进。
检测从哪里来
常见的 Frida 检测面,大致可以分成下面几类:
| 类型 | 典型特征 | 常见手段 |
|---|---|---|
| 只读段字符串 | frida:rpc、FridaScriptEngine、GumScript 等 |
strings、内存扫 .rodata |
| 线程名 | gum-js-loop、gmain、gdbus、frida-gadget-tcp-* 等 |
读 /proc/.../comm |
| 符号 | frida_agent_main、frida* 前缀 |
nm、内存导出符号 |
| maps 路径 | memfd:frida-agent 等 |
扫 /proc/pid/maps |
| 文件/进程名 | frida-server、frida-gadget.so |
文件系统、进程列表 |
| 配置指纹 | 默认端口 27042/27052、固定临时路径等 |
扫描、启发式 |
这些检测项看起来都像“字符串问题”,但实际上并不在一个层面上。
有些只是暴露名字,改掉就行;有些则直接参与运行时逻辑,尤其是协议相关字符串,这种东西不能简单全局替换,否则表面上看是把特征抹掉了,实际上是把功能也一起改坏了。
怎么过:按层处理,而不是全文替换
rusda 的处理思路并不是把 frida 两个字全局抹掉,而是分层来做。
1. 协议相关明文字:不直接写明文,运行时再还原
像 frida:rpc 这种字符串,不只是“好扫出来”那么简单,它本身就在 RPC JSON 里参与协议。
这类字符串如果直接在源码里替换成其它常量,协议就变了。要想既保留官方协议,又尽量不在磁盘和静态反汇编里直接暴露原串,就得换一种方式处理。
这里采用的是 XOR + 十六进制字面量:
- 源码里不直接出现
frida:rpc - 编译产物里只保留 XOR 后的 hex 串
- 运行时再解码回官方字符串
这样处理之后,磁盘文件和静态分析阶段看不到原始明文,但运行时内存里仍然会恢复成和官方一致的协议内容。
实现位置:
subprojects/frida-core/lib/base/obfuscate.vala
public static string decode_hex_xor (string hex) {
	var len = hex.length / 2;
	var sb = new StringBuilder.sized (len);
	for (var i = 0; i < len; i++) {
		int64 val;
		int64.try_parse (hex.substring (i * 2, 2), out val, null, 16);
		var b = (uint8) val;
		sb.append_c ((char) (b ^ XOR_KEY));
	}
	return sb.str;
}
subprojects/frida-core/lib/base/rpc.vala
private static string get_rpc_str (bool quoted) {
	var s = Obfuscate.decode_hex_xor ("33273c31346f272536");
	return quoted ? "\"" + s + "\"" : s;
}
这里顺带提一句,Frida-gum 里内嵌的一些 JS 资源如果仍然带着 frida:rpc,那么只改 core 这一层并不能完全覆盖。所以这种处理方式更准确地说,是把核心路径先处理掉,而不是宣称“全仓库所有相关明文都已经消失”。
2. .rodata 中的类型名和组件名:做等长反转
像 FridaScriptEngine、GLib-GIO、GDBusProxy、GumScript 这一类字符串,更多属于类型注册名、组件名或者调试可见名,常见于只读段,比较适合做静态处理。
这部分采用的是 等长反转写回 .rodata。思路比较直接:不改长度,只把原字符串字节序反过来,这样既不会引入额外长度问题,也能避免被简单的固定模式直接命中。
subprojects/frida-core/src/topatch.py
all_patch_string = ["FridaScriptEngine", "GLib-GIO", "GDBusProxy", "GumScript"]

for section in binary.sections:
    if section.name != ".rodata":
        continue
    for patch_str in all_patch_string:
        addr_all = section.search_all(patch_str)

        for addr in addr_all:
            patch = [ord(n) for n in list(patch_str)[::-1]]
            binary.patch_address(section.file_offset + addr, patch)
这种方式的优点是实现简单、对布局影响小,缺点也很明显:可读性会下降,而且它只适合处理这种“能改外观、不影响语义约定”的字符串,不适合拿去处理协议 token。
3. 符号:统一改名前缀
符号表同样是很常见的一层特征,尤其是导出符号或者内存导出之后,很多名字是比较显眼的。
这里的处理主要有两类:
frida_agent_main直接改成main- 其余包含
frida/FRIDA的符号,统一替换为约定前缀,例如rusda
对应实现:
for symbol in binary.symbols:
    if symbol.name == "frida_agent_main":
        symbol.name = "main"
    if "frida" in symbol.name:
        symbol.name = symbol.name.replace("frida", random_name)
    if "FRIDA" in symbol.name:
        symbol.name = symbol.name.replace("FRIDA", random_name)
这里有一个比较容易忽略的点:符号改名是有联动影响的。
比如 core 侧把 frida_agent_main 改成了 main,那么 gum 或测试代码里凡是仍然引用旧名字的地方,也要同步跟上。否则有可能出现一种比较烦的情况:构建阶段没报错,结果运行阶段符号解析失败。
4. 线程名:哪些能直接换,哪些不能乱动
线程名这层的检测很常见,很多检测脚本就是直接读 /proc/pid/task/*/comm。
典型特征包括:
gum-js-loopgmaingdbusfrida-gadget-tcp-<port>
对于前面几类,直接做二进制级替换问题不大,例如:
gum-js-loop→russellloopgmain→rmaingdbus→rubus
但是 frida-gadget 不能简单全文替换。这点在实操里很关键,因为它不只是一个线程名字面量,还是 frida-gadget-tcp-<port> 的前缀子串,injector 那边往往会按这个格式去匹配。
如果这里粗暴做全局替换,就很容易把原本依赖 ^frida-gadget-tcp-(\d+)$ 这一类规则的逻辑给破坏掉。
所以 topatch 里不会对 frida-gadget 做无差别 sed。Gadget 相关前缀更适合在源码层通过约定方式处理,而不是在最终产物上全局替换。
这一点其实也能说明一个问题:不是所有暴露出来的字符串都能按同一种方式“抹掉”。只要某个字符串还参与匹配、协商或者逻辑分支,就必须按语义来处理,而不是只看它长得像不像特征。
5. maps 上的路径和 memfd 显示名
Frida 17 开始,后端已经更多尝试通过 memfd 加载。这样做之后,maps 里原本为空的 Pathname,往往会变成类似:
/memfd:frida-agent (deleted)
它确实不再是传统意义上的“匿名映射”了,这能规避掉一部分专门盯着 00:00 0 节点号的简易检测脚本;但问题在于,名字本身还是很显眼。
因此这部分也可以继续往前走一步,把 memfd 显示名改成和 frida 无关的常量,比如 jit-cache 之类,以减少基于 maps 路径前缀的直接命中。
6. 产物命名:把最表层特征先压下去
还有一层最直接的检测面,就是文件名和进程名本身。
这一层虽然最浅,但也确实最容易被命中,所以 Meson 产出的二进制名称也做了统一调整,例如:
frida-server→rusda-serverfrida-inject→rusda-injectfrida-gadget.so→rusda-gadget.so
它不能解决深层问题,但能有效降低文件系统、进程列表这类最表层扫描的命中率。
关键实现节选
这里放一下几个核心片段,基本就能对应上前面提到的几层处理。
subprojects/frida-core/lib/base/obfuscate.vala
public static string decode_hex_xor (string hex) {
	var len = hex.length / 2;
	var sb = new StringBuilder.sized (len);
	for (var i = 0; i < len; i++) {
		int64 val;
		int64.try_parse (hex.substring (i * 2, 2), out val, null, 16);
		var b = (uint8) val;
		sb.append_c ((char) (b ^ XOR_KEY));
	}
	return sb.str;
}
subprojects/frida-core/lib/base/rpc.vala
private static string get_rpc_str (bool quoted) {
	var s = Obfuscate.decode_hex_xor ("33273c31346f272536");
	return quoted ? "\"" + s + "\"" : s;
}
subprojects/frida-core/src/topatch.py
for symbol in binary.symbols:
    if symbol.name == "frida_agent_main":
        symbol.name = "main"
    if "frida" in symbol.name:
        symbol.name = symbol.name.replace("frida", random_name)
    if "FRIDA" in symbol.name:
        symbol.name = symbol.name.replace("FRIDA", random_name)

all_patch_string = ["FridaScriptEngine", "GLib-GIO", "GDBusProxy", "GumScript"]

for section in binary.sections:
    if section.name != ".rodata":
        continue
    for patch_str in all_patch_string:
        addr_all = section.search_all(patch_str)

        for addr in addr_all:
            patch = [ord(n) for n in list(patch_str)[::-1]]
            binary.patch_address(section.file_offset + addr, patch)
Frida 17 带来的变化
这次重新看 17.6.2,还有一个比较直观的感受:不少以前很敏感的暴露点,官方自己也在往收敛的方向做。
方法 A:利用 memfd_create 消除“匿名”标签
Frida 17 在后端加载链路里已经开始尝试通过 memfd 装载,更新记录里也能看到类似 Load backend through memfd with fallback 的描述。
原理上,就是用 memfd_create 在 RAM 中创建一个虚拟文件,再对该文件执行 mmap。
效果是,maps 里原本可能为空的 Pathname,会显示成 /memfd:frida-agent (deleted) 这一类形式。虽然仍然有痕迹,但它已经不属于传统的匿名映射,对于那种专门扫 00:00 0 的极简脚本来说,确实能避开一部分。
方法 B:使用 Frida 17 收敛后的 Memory.patchCode
以前很多人的习惯是 Memory.alloc 之后直接配合 Memory.protect(..., 'rwx'),或者自己长期维护一块可写可执行内存。这种方式在现在这个环境下其实是比较显眼的。
Frida 17 对代码修补路径做了一些收敛,官方更倾向于在真正写入 trampoline 的瞬间才短暂打开写权限,而不是长时间维持 rwx。
在实践里,如果直接走 Interceptor 或 Process.setExceptionHandler 这类官方路径,很多时候权限切换会由 Frida 自己处理,大多数时间内相关页面仍然可以保持为 r-x。这一点虽然谈不上“隐身”,但相比老习惯,暴露面确实小一些。
方法 C:代码空洞注入(Code Cave)
再往前走一步,就是尽量不申请新的可疑映射,而是去找已有合法映射中的 padding、对齐空洞或者可利用区域,把跳板直接写进文件支撑的映射空间。
这样 maps 里看到的还是正常库路径,例如 /system/lib/libc.so,而不是一块新出现的可疑匿名页或临时页。
不过这一层已经超出本文仓库当前 patch 的范围了。更准确地说,它属于更深层的注入落点设计问题,可以作为后续方向讨论,但不应和本文这套字符串、符号、线程名层面的处理混在一起。
为什么魔改之后依旧无法彻底过掉检测
这个问题其实反而是最值得说清楚的。
魔改能做的,主要还是处理一部分比较显式、比较浅层的特征,比如:
.rodata里的明文字符串/proc/pid/task/*/comm里的线程名- ELF 符号
/proc/pid/maps里的路径前缀- 文件名、进程名、默认端口等配置级指纹
这些东西处理完之后,确实能降低被简单规则直接命中的概率;但它解决不了所有问题,尤其解决不了更深层的完整性校验。
比如有些检测并不关心你是不是叫 Frida,而是直接检查:
libc或其它关键 so 的代码段、数据段有没有被改动- GOT 表里关键函数地址还在不在原始 libc 范围内
- inline hook 之后的指令字节有没有变化
- 某些关键 API 或 syscall 的行为有没有偏离预期
这类检测关注的是“有没有被动过”,而不是“名字有没有改干净”。
所以说,魔改 Frida 本质上只是把一些浅层特征做了处理,不是改完就能过所有检测。如果有人把这件事讲成“改个字符串、改个线程名就天下无敌”,那大概率还是噱头更多一点。
与旧版本思路的区别
如果你用的是更早期的一些方案,常见问题一般集中在下面两点:
- 通过 ptrace 长时间跟踪 Zygote,再配合比较复杂的 syscall 追踪去等注入时机。这种方式容易因为
TracerPid异常被 RASP 检测到,而且稳定性也一般,严重时还可能把系统拖崩。 - 依赖
frida-java-bridge注入system_server。这种方案对系统版本和环境变化比较敏感,很多时候兼容性问题会比想象中多。
而 Frida 17 的方向,明显是在尽量减轻这些旧路径带来的高暴露问题:
- Android 注入机制更轻量化
- 不再长期占用旧式 ptrace 路径
- 对
system_server的依赖降低
这些改动确实让一些老检测点不再像以前那样有效,但也不能因此就把新版本理解成“天然免疫检测”。它只是把问题从过去那种特别显眼的系统层暴露,往更细、更深的层面重新分布了而已。
结语
rusda 这套魔改的意义,我觉得不在于宣称“完全绕过检测”,而在于提供了一套比较清晰的工程化思路:
- 协议相关字符串,不直接改语义,而是隐藏其静态落盘形式
- 非协议字符串、符号、线程名、maps 显示名、产物名称,分别按层处理
- 能借用 Frida 17 新机制降低暴露面的地方,就尽量顺着新机制走
但也必须承认,它主要解决的还是“特征隐藏”层的问题。真要面对完整性校验、行为检测、系统调用追踪或者更深层的运行时对抗,单靠这一层 patch 远远不够。
如果把它理解成“让产物不那么容易被简单扫出来”,这个方向是成立的;如果把它理解成“改完就能全面免疫检测”,那就高估它了。
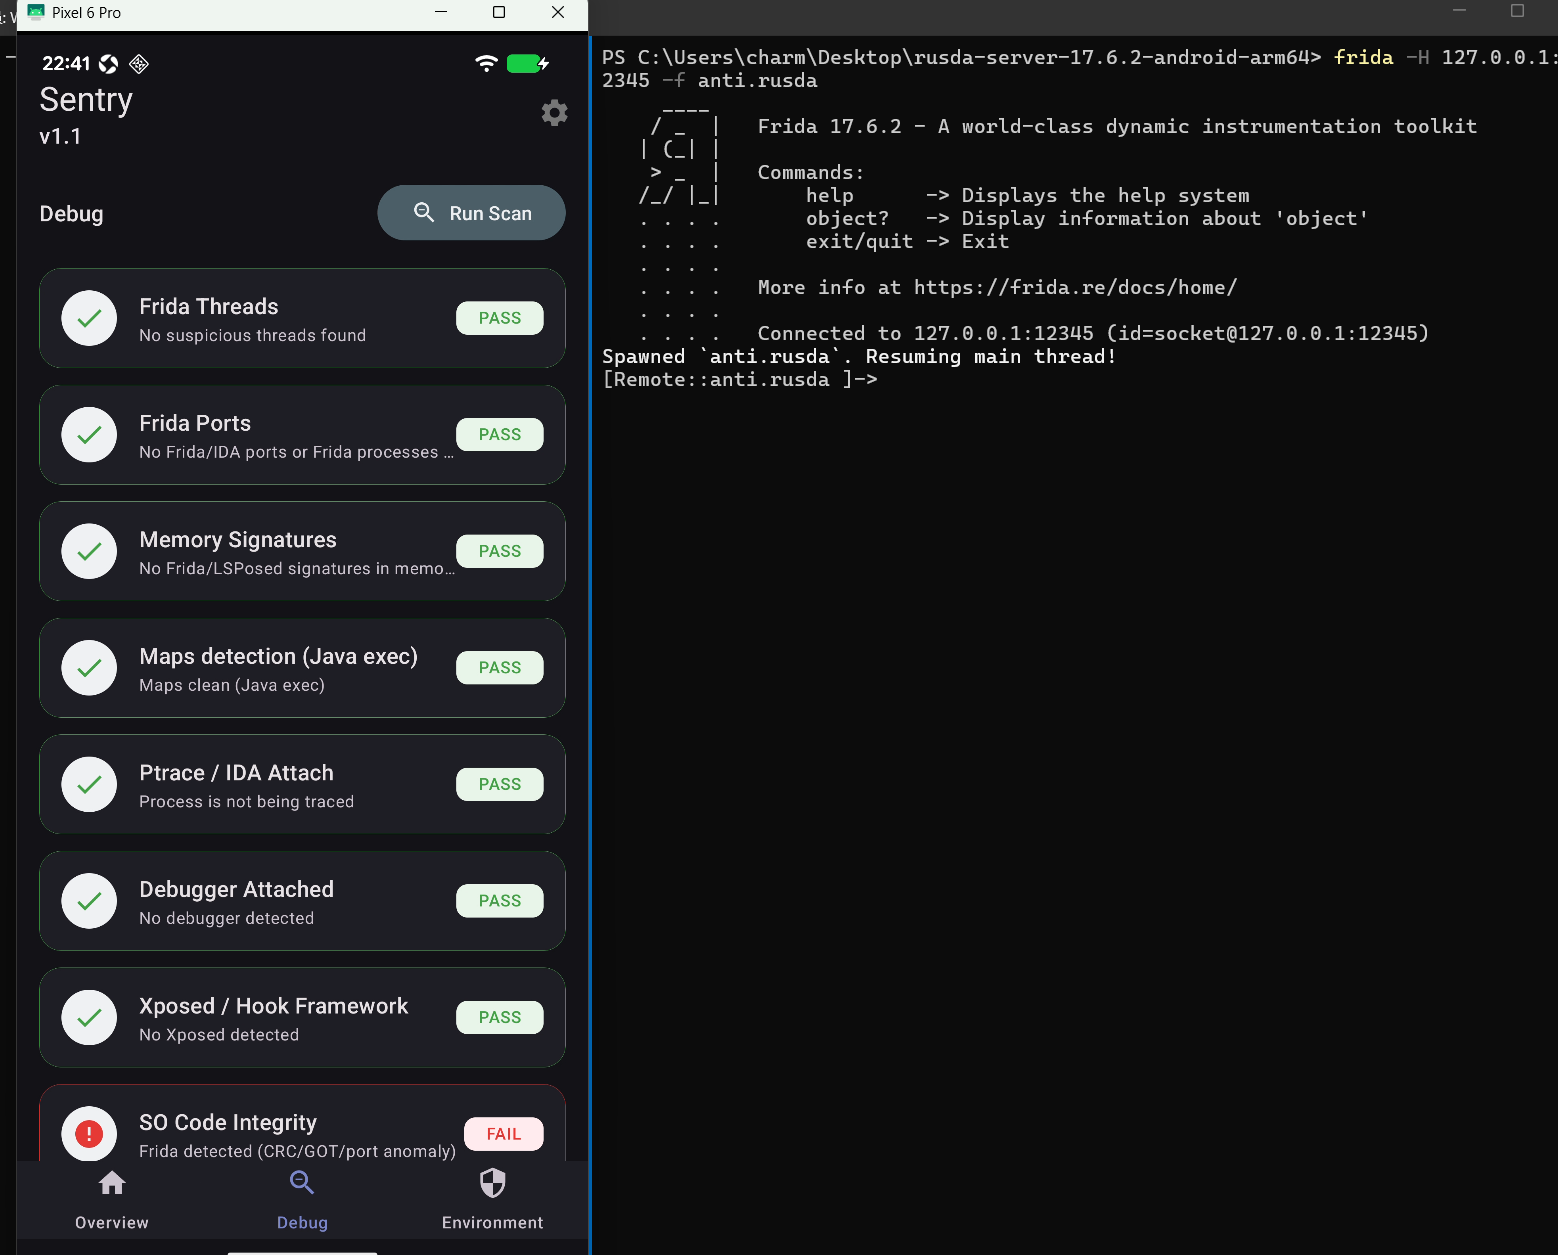
效果展示
检测工具:https://github.com/taisuii/sentry
原版
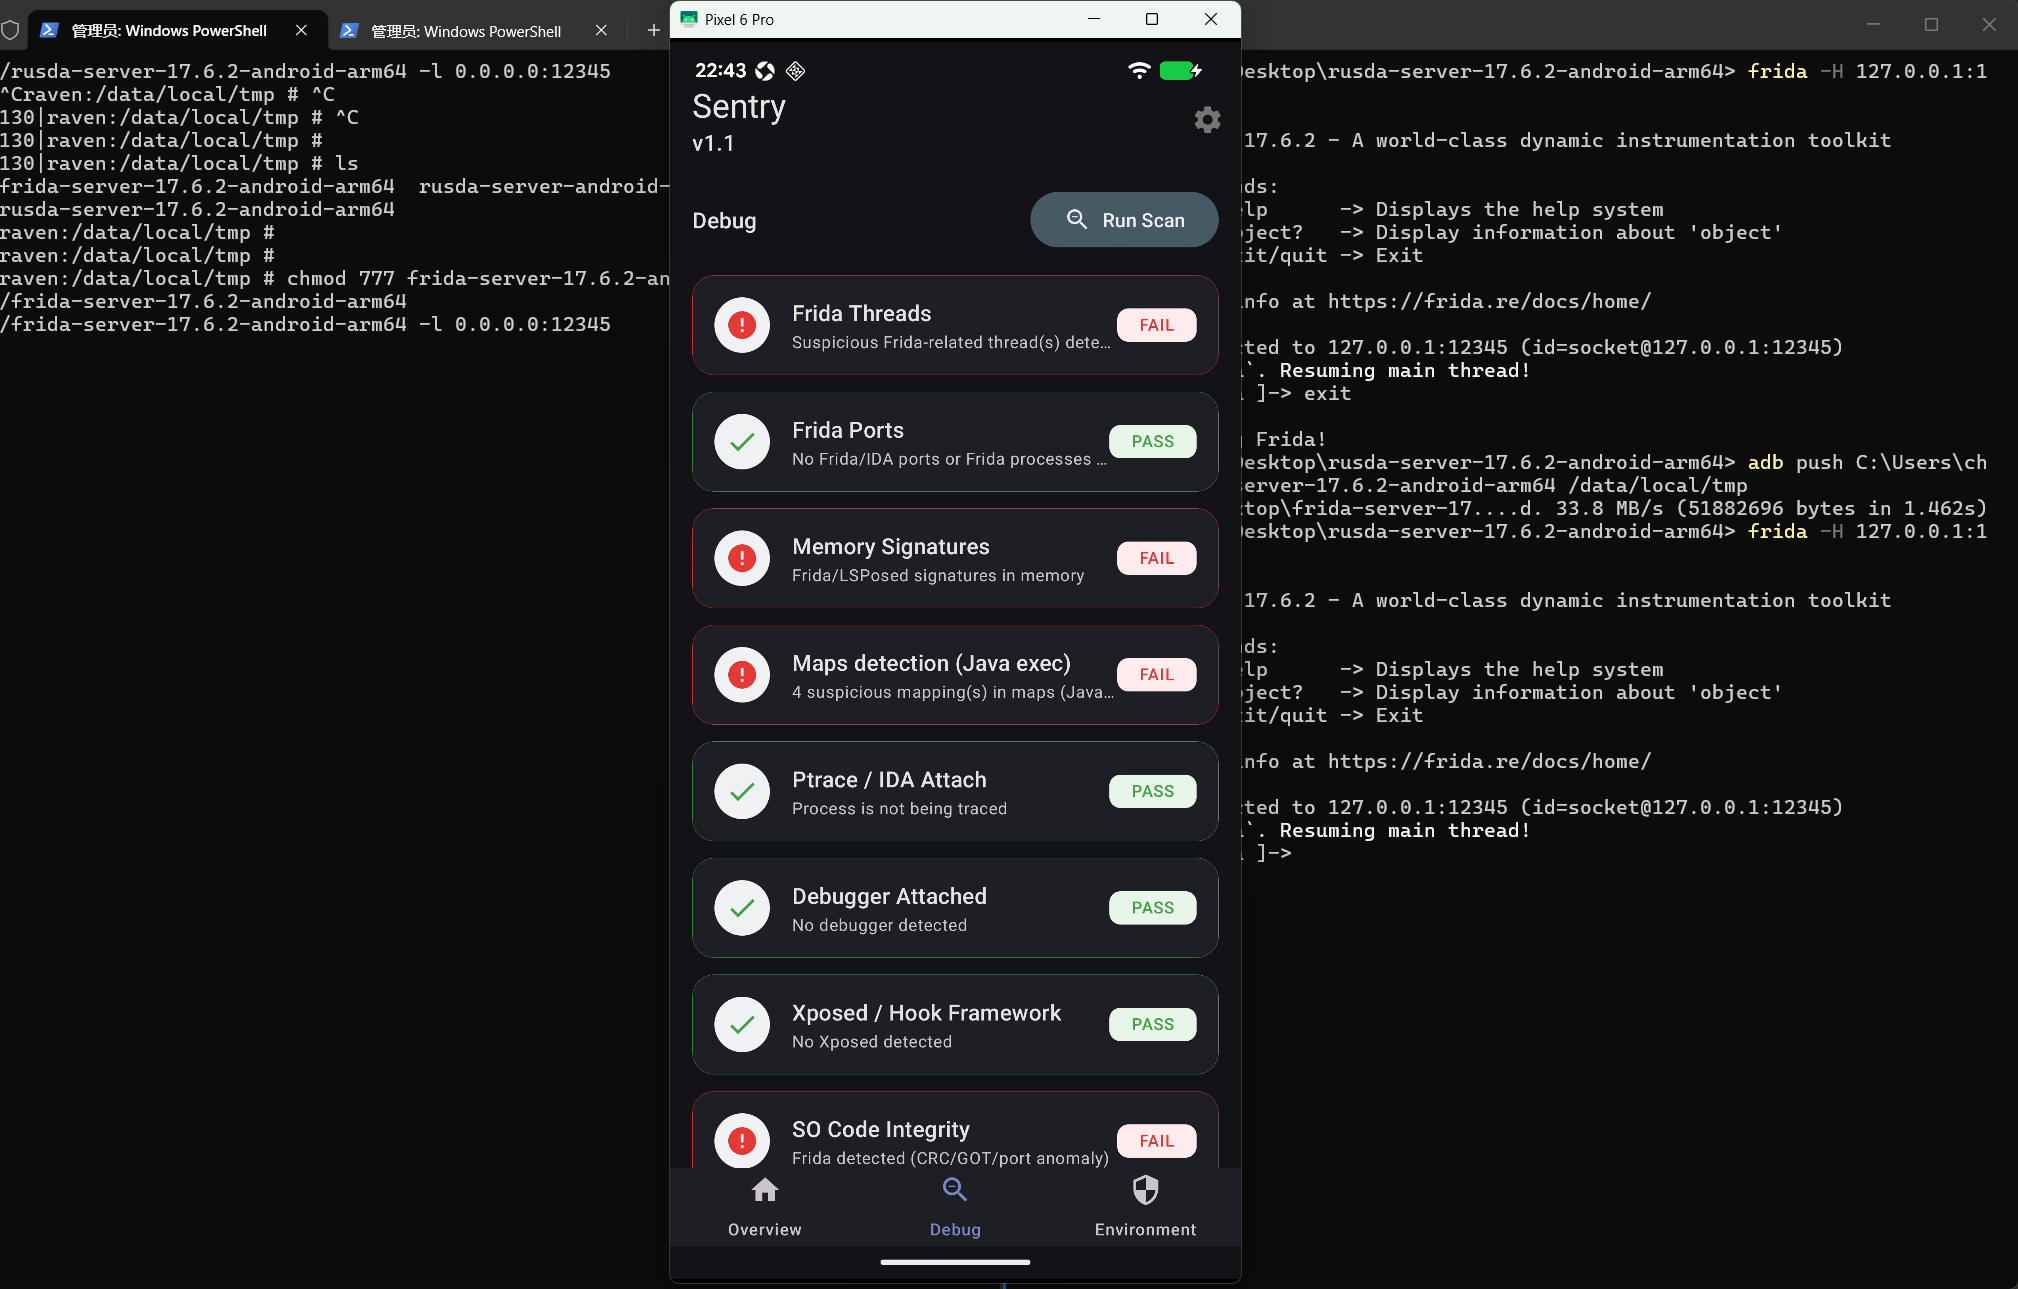
魔改版
评论
登录后参与讨论,回复会带你回到这里。
登录参与讨论还没有评论,来抢沙发。